온프레미스 LLM 구축
데이터가 외부로 나가지 않는 AI 인프라
외부 API 없이 자체 GPU 서버에서 LLM을 직접 구축·운영합니다.
금융·공공기관의 망분리 환경에서도 고객 데이터를 한 줄도 내보내지 않고 AI를 도입할 수 있습니다.
외부 API 없이 자체 GPU 서버에서 LLM을 직접 구축·운영합니다.
바능은 Qwen · DeepSeek · Flux 등 오픈 모델을 자체 GPU 서버에서 직접 서빙합니다. 상용 API에 의존하지 않기 때문에 금융·공공기관의 망분리 환경에서도 AI를 그대로 도입할 수 있고, 고객의 데이터가 외부 서버로 전송되지 않는다는 점이 가장 강력한 차별점입니다.
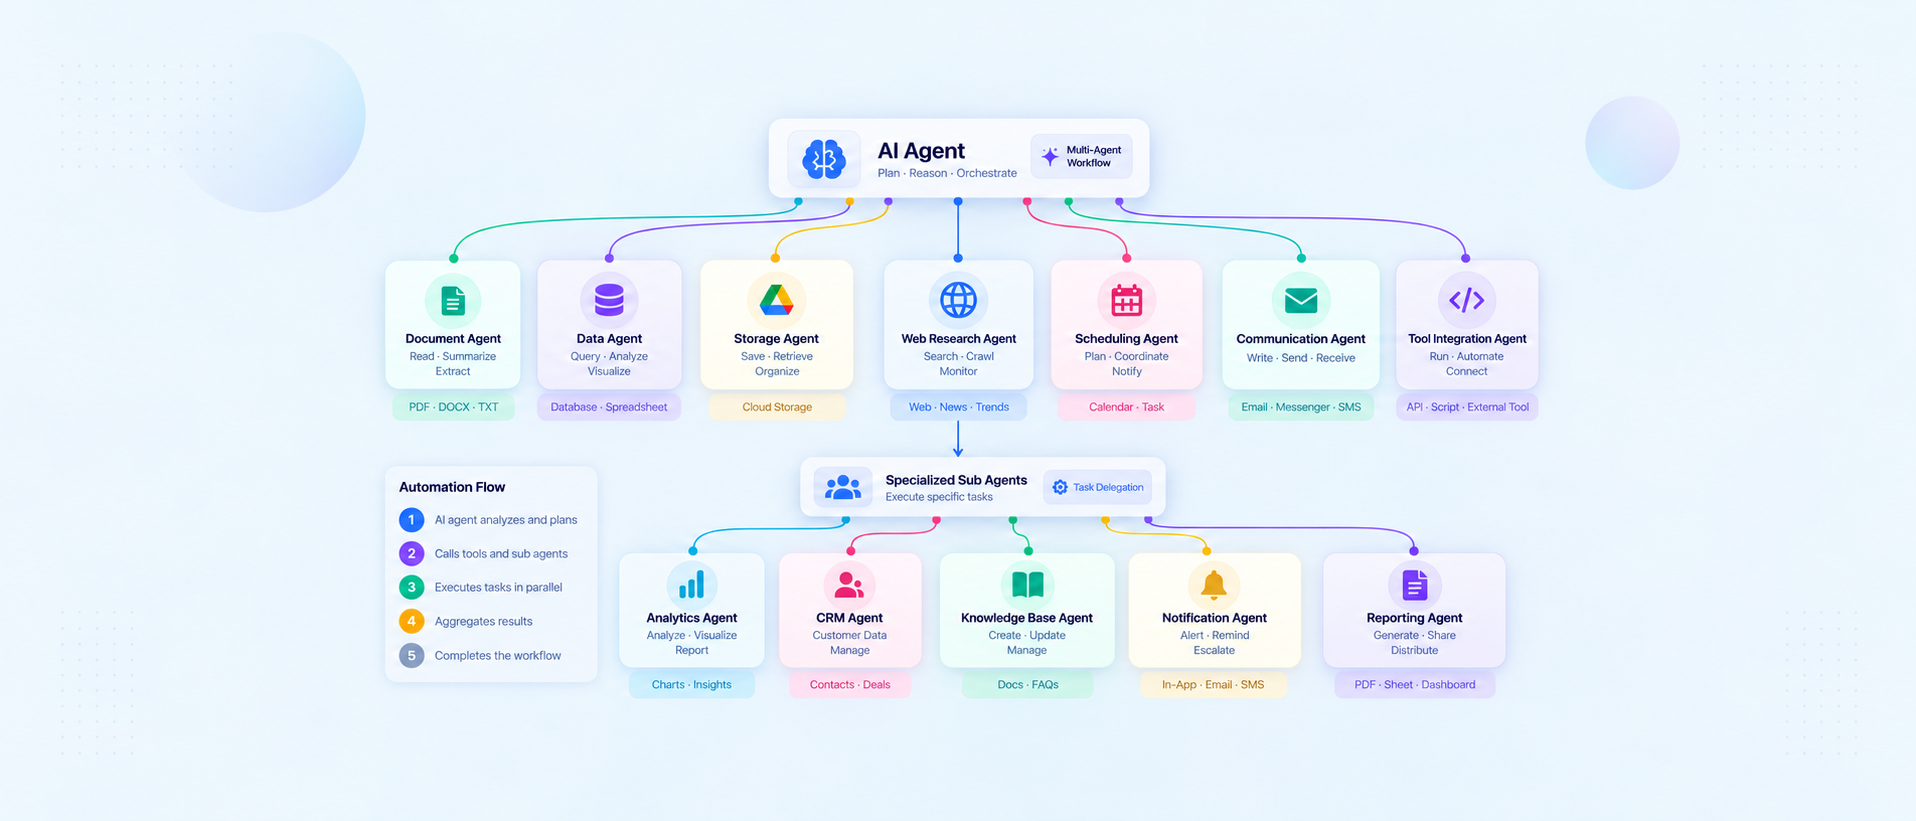
범용 AI가 아니라 우리 업무를 아는 AI를 만듭니다. 금융 약관, 반도체 공정 문서, 공공 법령처럼 도메인 특화 데이터로 모델을 파인튜닝하고, 자주 바뀌는 정보는 RAG 아키텍처로 실시간 반영합니다. 구축한 모델은 Spring Boot API와 React 프론트엔드로 실제 업무 시스템에 연결됩니다.
바능이 직접 수행하는 일
온프레미스 LLM 서빙
Qwen · DeepSeek · Flux 등 오픈 모델을 고객사 GPU 서버에 설치·운영합니다. 모델 선정부터 서빙 최적화, 리소스 설계까지 맡습니다.
도메인 특화 파인튜닝
LoRA / QLoRA 기반으로 고객사 문서와 용어를 학습시켜, 클라이언트의 시스템 언어를 그대로 이해하는 모델을 만듭니다.
RAG 아키텍처
Vector DB와 Elasticsearch를 결합한 하이브리드 검색으로 최신 문서를 실시간 참조합니다. 임베딩 파이프라인 구축까지 포함합니다.
보안·망분리 대응
데이터 무반출 원칙, 접근 통제, 감사 로그를 설계에 반영해 금융·공공의 보안 심사 기준을 충족합니다.
운영·고도화
GPU 리소스 모니터링, 모델 버전 관리, 품질 평가 체계를 갖춰 도입 이후에도 성능을 지속 개선합니다.
이렇게 진행합니다
현황·데이터 진단
적용 업무, 보유 데이터, 보안 요건을 파악하고 온프레미스 도입 범위를 정의합니다.
모델 선정·PoC
후보 모델을 실제 업무 데이터로 검증해 정확도·속도·비용을 비교합니다.
파인튜닝·RAG 구축
도메인 데이터 학습과 검색 파이프라인을 구축하고 평가 지표로 품질을 확인합니다.
서비스 연동
Spring Boot API · React 화면으로 기존 시스템과 연결해 실제 업무 흐름에 배치합니다.
운영·고도화
모니터링과 재학습 주기를 정해 모델과 데이터를 지속적으로 갱신합니다.
사용하는 기술
- 모델
- QwenDeepSeekFlux
- 학습·검색
- Fine-tuningLoRA / QLoRARAGVector DBEmbeddingElasticsearch
- 서빙·연동
- 자체 GPU 서버Spring Boot APIReact / Next.js